1. 개념
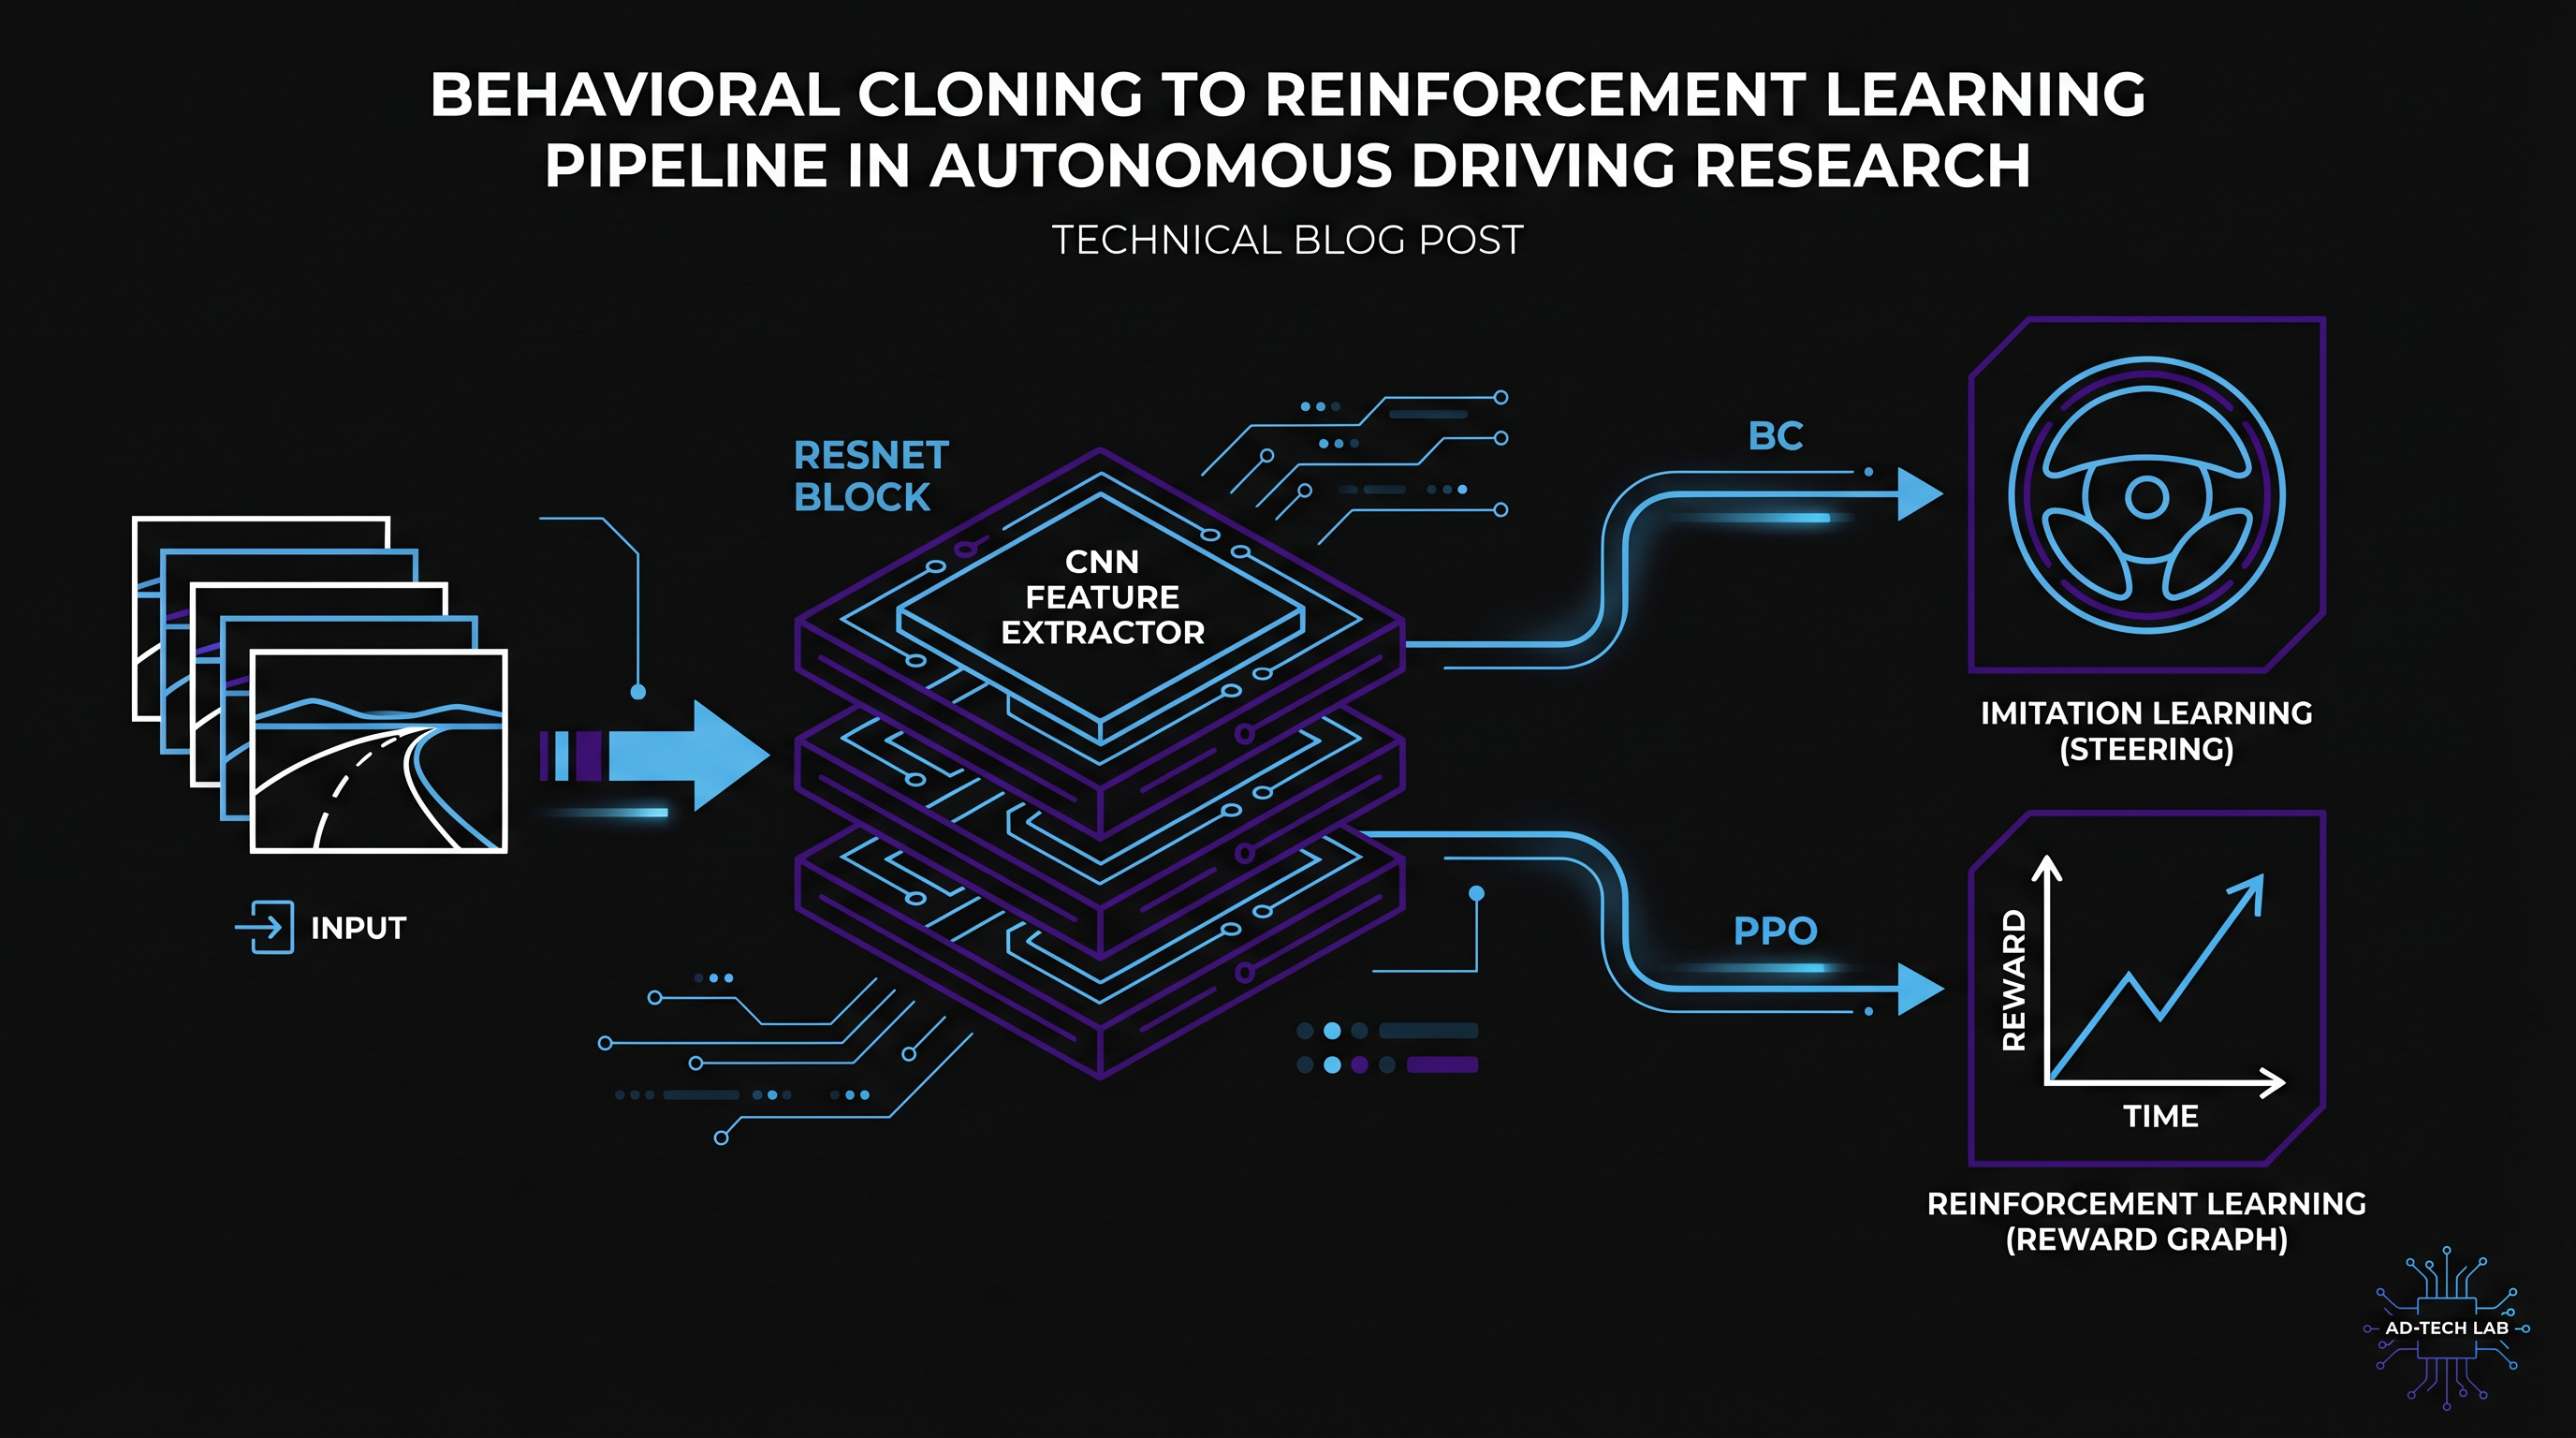
행동 복제(Behavioral Cloning, BC)는 모방 학습(Imitation Learning)의 가장 기본적인 형태로, 전문가의 행동을 지도학습(Supervised Learning) 방식으로 직접 모방하는 기법입니다.
자율주행 맥락에서는 다음과 같이 정의됩니다:
“전문가(또는 autopilot)의 (관측, 행동) 쌍 데이터셋 $D = {(o_i, a_i)}{i=1}^N$로부터, 관측을 입력받아 행동을 출력하는 정책 $\pi\theta(a o)$를 학습한다.”
2. 학습 목적 함수
회귀(Regression) 형태의 손실 함수가 일반적으로 사용됩니다.
\[\mathcal{L}_{BC}(\theta) = \mathbb{E}_{(o, a) \sim D} \left[ \| \pi_\theta(o) - a \|^2 \right]\]조향(steering)과 가속(throttle)을 동시에 출력하는 경우, 각 출력에 대한 MAE 또는 MSE를 더하는 멀티태스크 회귀 형태로 설계합니다.
3. 숭산텍 프로젝트에서의 BC
3.1 모델 아키텍처
| 구성 | 사양 |
|---|---|
| Backbone | ResNet18 (ImageNet pretrained) |
| 입력 | Front RGB 224×224 |
| 출력 | (steering, throttle) 2차원 연속값 |
| FC Head | 512 → 256 → 2 |
3.2 학습 데이터
- 데이터 소스: CARLA autopilot 주행 로그
- 수집 주기: 10Hz
- 다양성: 9가지 날씨×시간대 조합 (Clear/Rain/Fog × Day/Night/Backlight)
3.3 평가 메트릭
| 메트릭 | 목표 |
|---|---|
| MAE Steering | < 0.10 |
| MAE Throttle | < 0.08 |
| 교차로 통과율 | > 80% (10회 중 8회) |
4. 한계와 보완
BC는 학습 데이터의 분포에서 벗어나는 상태(Out-of-Distribution)에서 성능이 급격히 저하되는 Distribution Shift 문제가 있습니다. 이를 보완하기 위해 숭산텍은 다음 전략을 사용합니다:
- 데이터 증강: 다양한 날씨·시간대 조합으로 학습 분포를 확장
- 노이즈 주입: autopilot 제어값에 의도적 노이즈를 주입하고 복구 궤적을 학습 (DAgger의 변형)
- RL 미세조정: BC로 학습한 정책을 PPO로 fine-tuning하여 분포 외 상황에 대응